KI-Preismodelle 2026: die KI-Preistreppe vom Token-Preis zum Preis je Ergebnis
Dr. Oliver Gausmann · 10. August 2026 · 16 Min.
Artikel mit KI zusammenfassen
TL;DR
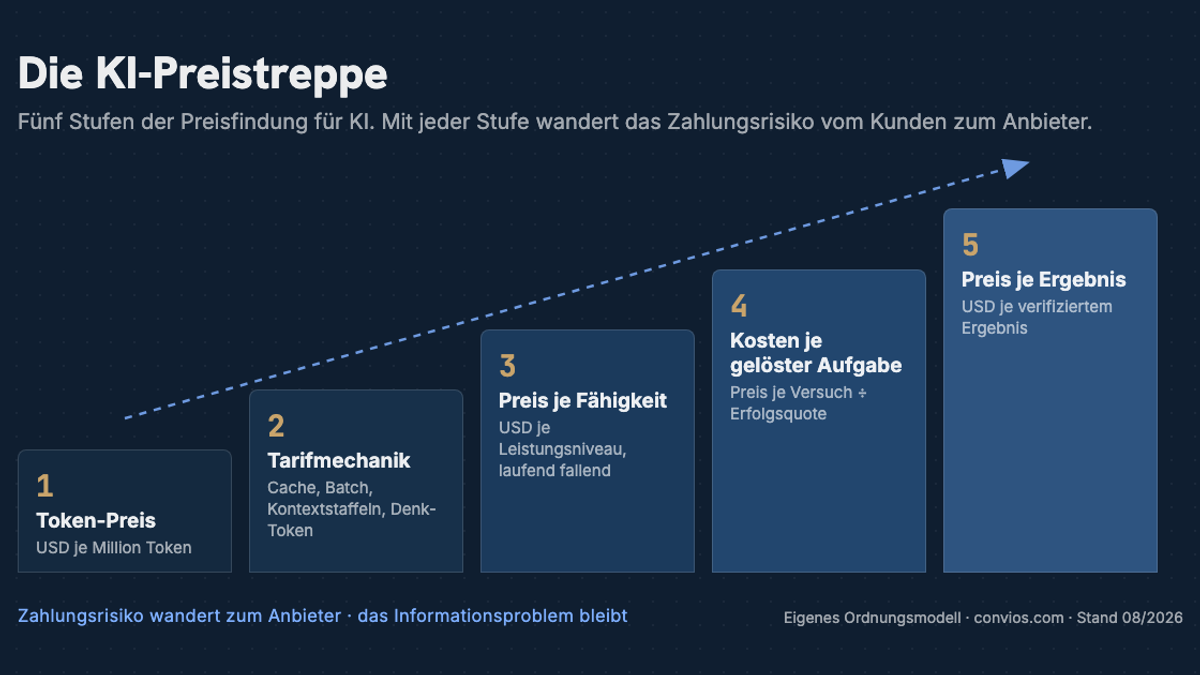
KI-Preismodelle sortieren sich 2026 neu, weil KI anders als klassische Software bei jeder einzelnen Nutzung Rechenkosten verursacht: Anbieter von KI-Produkten kalkulieren im Median mit rund 50 Prozent Bruttomarge statt der SaaS-üblichen 80 [1]. Die KI-Preistreppe ordnet das Feld in fünf Stufen, vom Token-Preis über die Kosten je gelöster Aufgabe bis zum Preis je Ergebnis. Der Listenpreis allein trägt dabei nicht weit, denn in 32 Prozent der untersuchten Modellpaare verursacht das billiger gelistete Modell die höheren Gesamtkosten [2]. Hybride KI-Preismodelle sind binnen eines Jahres von 25 auf 37 Prozent der Anbieter gesprungen [1]. Der Preis je Ergebnis nimmt dem Kunden dabei vor allem das Zahlungsrisiko ab; ob das Ergebnis etwas taugt, misst weiterhin meist der Anbieter selbst. Wer einkauft, verhandelt deshalb zuerst die Zähleinheit und dann den Preis.
Ich pflege auf meiner Website einen Kostenrechner mit 75 KI-Modellen, und der hat mir eine Lektion erteilt. Zweimal in zwei Wochen war mein Preisstand veraltet, ohne dass ein einziger Test anschlug: Einmal stand ein Modell fünffach zu hoch, einmal hatte ein Anbieter eine zweite Preisstufe für lange Eingaben nur als Fußnote unter der Preistabelle vermerkt. Am 30. Juli senkte OpenAI dann den Preis eines drei Wochen alten Modells um 80 Prozent [3].
Wer KI einkauft oder selbst bepreist, arbeitet auf einem Markt, dessen Preisschilder sich schneller drehen als jeder Budgetzyklus. Das wirkt chaotisch, folgt aber einer Ordnung, die man in fünf Stufen fassen kann. Ich nenne sie die KI-Preistreppe: Token-Preis, Tarifmechanik, Preis je Fähigkeit, Kosten je gelöster Aufgabe, Preis je Ergebnis. Mit jeder Stufe wandert das Zahlungsrisiko ein Stück weiter vom Kunden zum Anbieter.
Jede KI-Antwort kostet Geld, deshalb wackeln alle Preismodelle
Eine verkaufte Softwarelizenz kostete den Anbieter im Betrieb fast nichts mehr. Auf dieser Grenzkostenlogik ruhten zwanzig Jahre Abo-Preise. KI bricht sie, weil jede Antwort Rechenzeit auf teurer Hardware verbraucht, und die Rechnung dafür kommt beim Anbieter jeden Monat an.
Die Folgen stehen inzwischen in den Erhebungen. Anbieter von KI-Produkten peilen im Median rund 50 Prozent Bruttomarge an, nur 12 Prozent halten die SaaS-üblichen 80 Prozent für erreichbar [1]. Eine zweite, unabhängig erhobene Stichprobe kommt auf projizierte 52 Prozent für 2026 [4]. Dazu sagen 70 Prozent der Anbieter, ihre Kunden bezahlten KI aus dem vorhandenen Software-Budget [1]. Der Spielraum für Preisfehler ist also klein, und trotzdem tastet die Branche: 76 Prozent der Software-Anbieter haben KI-Funktionen eingeführt, doch die Mehrheit berichtet von einer Umsatzwirkung unter 10 Prozent [5].
Für die folgenden Stufen hilft ein konkreter Fall, den ich durch den ganzen Text trage: ein Unternehmen mit 10.000 Kundenanfragen im Monat, die eine KI beantworten soll. An diesem einen Arbeitsvolumen lässt sich jede Stufe der KI-Preistreppe durchrechnen.
Was kostet ein Token wirklich?
Die unterste Stufe klingt beruhigend einfach. Sprachmodelle rechnen in Token ab, kleinen Textstücken von ein paar Zeichen, mit Listenpreisen je Million. Unsere 10.000 Kundenanfragen mit je rund 3.700 Token Umfang kosten auf einem günstigen Modell etwa 37 US-Dollar im Monat, die Zahl stammt aus der Preisdokumentation von Anthropic selbst [6]. Bis hierhin rechnet das jeder Praktikant nach.
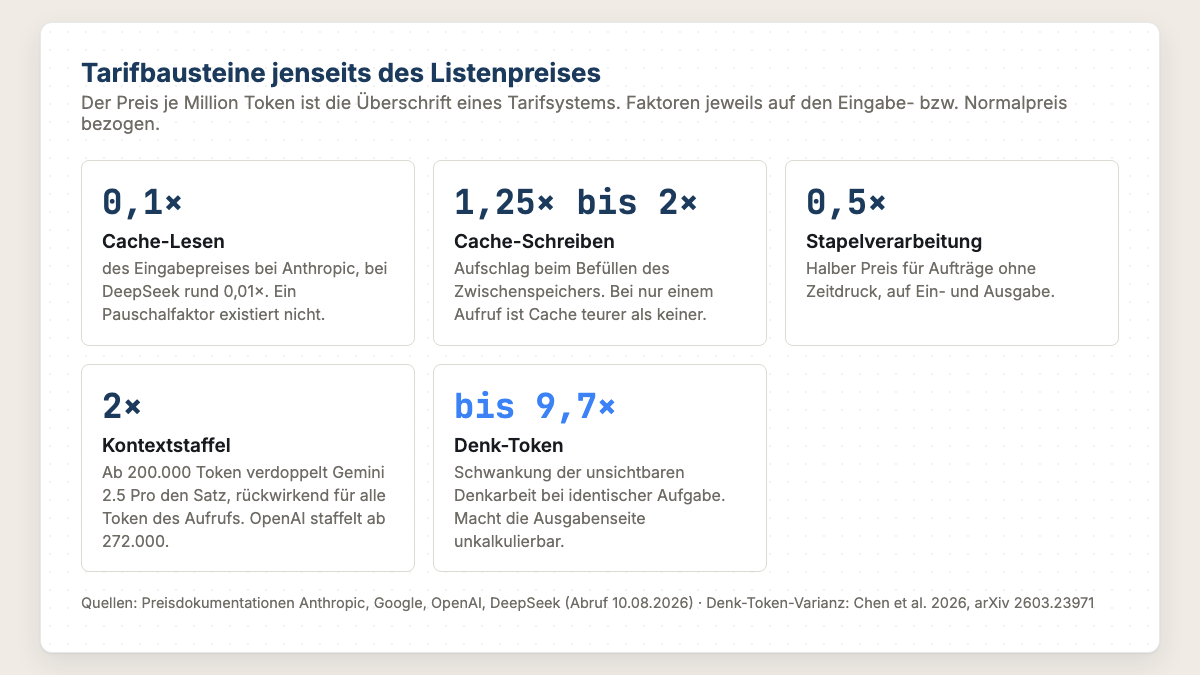
Der Tarif dahinter, Stufe zwei der Treppe, hat mehr bewegliche Teile. Wiederkehrende Eingaben lassen sich zwischenspeichern, das Lesen aus diesem Cache kostet bei Anthropic nur ein Zehntel des Eingabepreises, das Befüllen dafür einen Aufschlag von 25 Prozent bis 100 Prozent [6]. Bei DeepSeek kostet der Cache-Treffer sogar nur rund ein Prozent [7]. Für Aufträge ohne Zeitdruck halbiert die Stapelverarbeitung den Preis [6]. Und bei langen Eingaben führen mehrere Anbieter eine zweite Preisstufe, oft nur als Fußnote unter der Preistabelle vermerkt: Google verdoppelt beim Modell Gemini 2.5 Pro oberhalb von 200.000 Token den Satz, und zwar rückwirkend für alle Token des Aufrufs [8], OpenAI hebt bei mehreren Modellen ab 272.000 Token an [9]. Dazu kommt das Nachdenken: Moderne Modelle erzeugen beim Überlegen unsichtbare Denk-Token, die ganz normal auf der Rechnung landen und deren Menge bei identischer Aufgabe um das bis zu 9,7-Fache schwankt [2]. Die Ausgabenseite der Rechnung ist damit im Wortsinn unkalkulierbar geworden.
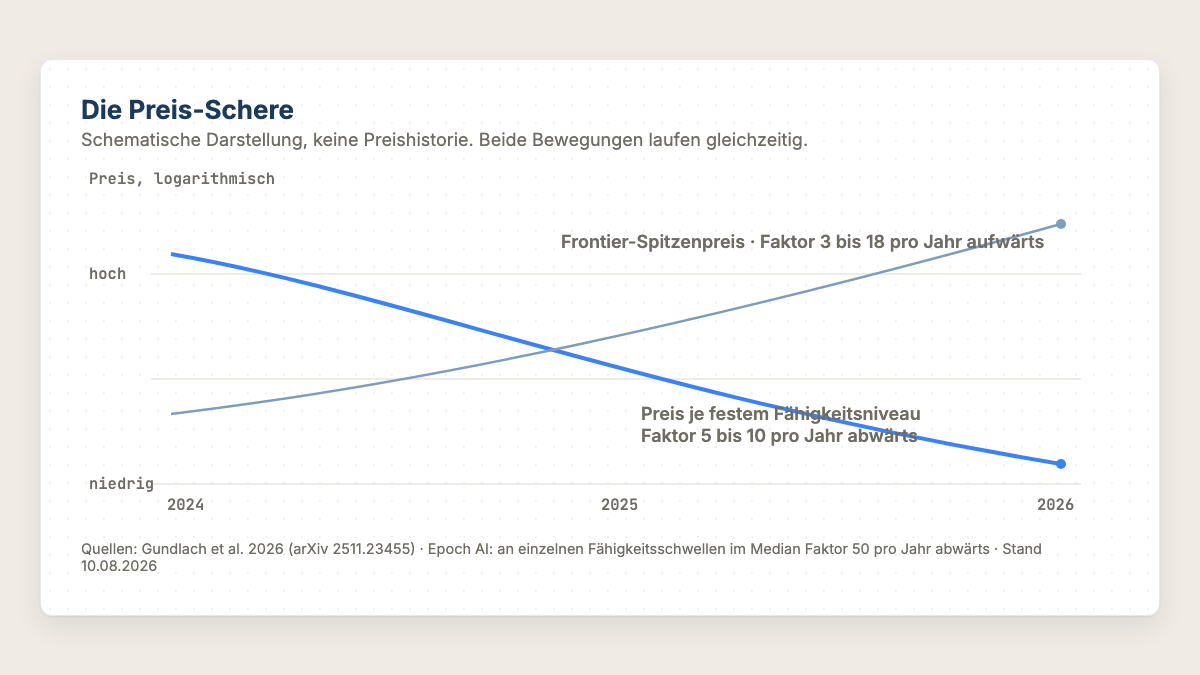
Die dritte Stufe der Treppe ist der Preis je Fähigkeit, und auf ihr liegt eine Preisdynamik, die beide Richtungen gleichzeitig kennt. Der Preis für ein festes Fähigkeitsniveau fällt um den Faktor 5 bis 10 pro Jahr [10], an einzelnen Leistungsschwellen gemessen im Median sogar um den Faktor 50 [11]. Der Spitzenpreis für das jeweils beste Modell steigt zugleich um den Faktor 3 bis 18 pro Jahr [10]. Deshalb erleben Unternehmen beides zugleich: Die gestrige Aufgabe wird laufend billiger, die neueste Ambition laufend teurer.
Die ehrliche Einheit ist die gelöste Aufgabe
Auf der vierten Stufe ändert sich die Frage: Was kostet es, bis eine Aufgabe erledigt ist? Die Forschung hat dafür seit 2025 eine schlichte Formel: Kosten je gelöster Aufgabe gleich Preis je Versuch geteilt durch Erfolgsquote [12]. Ein Modell, das halb so viel kostet, aber nur ein Drittel so oft richtig liegt, ist auf dieser Stufe das teurere.
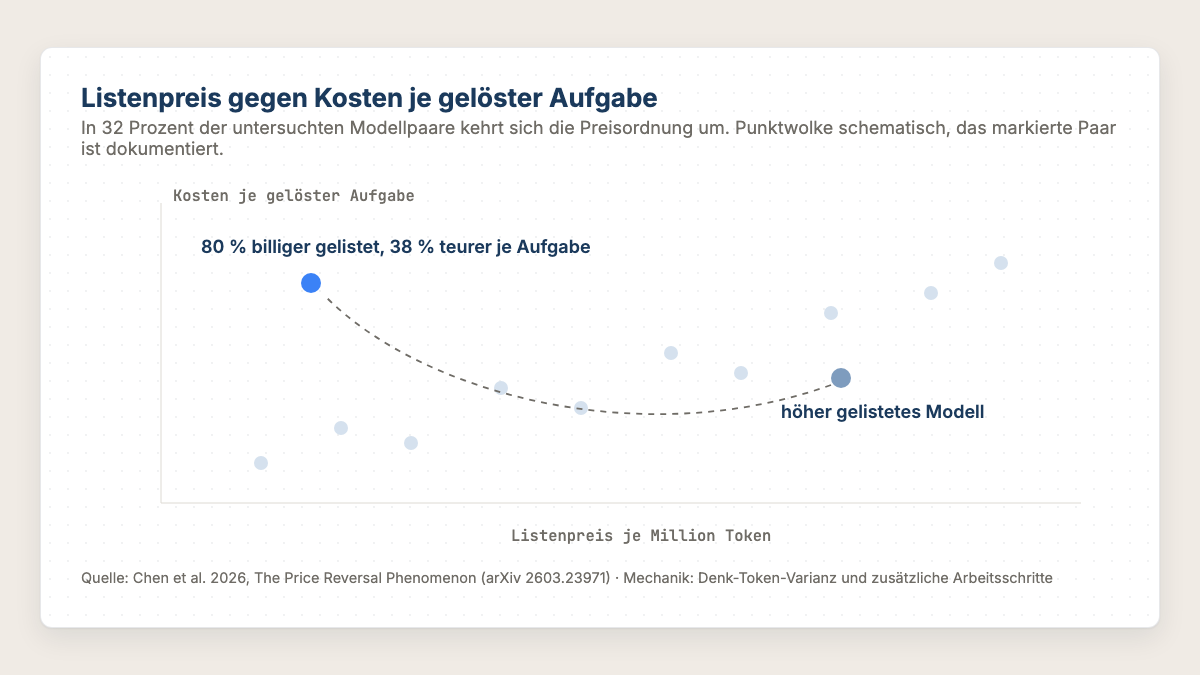
Wie oft die Listenpreise dabei in die Irre führen, hat eine im März veröffentlichte Studie beziffert: In 32 Prozent der Modellpaare verursacht das billiger gelistete Modell die höheren Gesamtkosten, im Extrem um das 28-Fache [2]. Ein Modell mit 80 Prozent niedrigerem Listenpreis kam über alle Aufgaben hinweg 38 Prozent teurer [2]. Die Studie führt das auf die schwankenden Denk-Token und zusätzliche Arbeitsschritte zurück [2]. Der Listenpreis versagt als Preissignal ausgerechnet dort, wo er am meisten verspricht.
Für unsere 10.000 Kundenanfragen heißt das: Die 37 Dollar von eben sind nur dann eine gute Zahl, wenn das günstige Modell die Anfragen auch löst. Bleibt jede fünfte Antwort unbrauchbar und ein Mensch arbeitet nach, steht die wahre Rechnung woanders. Ab wann sich das stärkste Modell trotz höherem Preis rechnet, lässt sich sogar beziffern: Sobald ein einzelner Fehler rund 10 Cent kostet, gewinnt fast immer das Spitzenmodell, so eine Caltech-Arbeit auf dem Preisstand von Mitte 2025 [13]. Das klingt niedrig, folgt aber aus dem Größenverhältnis: Was das Spitzenmodell je einzelner Anfrage mehr kostet, ist klein gegen das, was ein einziger vermiedener Fehler spart. Bei Kundenanfragen ist ein verlorener Kunde schnell teurer.
Diese Stufe ist der Grund, warum ich meinen Kostenrechner genau um diese Einheit gebaut habe, und die Kostenhebel dahinter habe ich in KI-Kosten senken durch Modellwahl auseinandergenommen.
Welche KI-Preismodelle setzen sich 2026 durch?
Oberhalb des Einkaufs beginnt die Anbieterseite der KI-Preistreppe, und dort läuft seit zwei Jahren eine Wanderung. 2024 bepreisten die meisten Software-Anbieter ihre KI-Funktionen wie gewohnt, als Aufpreis je Nutzer. Dann kam die Margenrechnung von oben, und seither probiert der Markt öffentlich neue Zähleinheiten aus.
Man kann dabei zusehen. Salesforce führt für seinen Service-Agenten zwei Verbrauchsmodelle parallel, 2 US-Dollar je Gespräch oder ein Guthabenmodell mit 10 Cent je Standard-Aktion, und welches günstiger ist, muss der Kunde selbst durchrechnen [14]. GitHub stellte Copilot zum 1. Juni 2026 auf Token-Guthaben um, die alten Pauschal-Kontingente entfielen [15]. Cursor wechselte sein Preismodell im Juni 2025 so unglücklich, dass das Unternehmen sich öffentlich entschuldigte und unerwartete Gebühren erstattete [16]. Und auf der fünften Stufe, dem oberen Ende der Treppe, steht seit 2026 das Ergebnis selbst auf der Preisliste: Intercom berechnet 0,99 US-Dollar je erreichtem Ergebnis, gezählt als bestätigt gelöstes Anliegen oder abgeschlossener Arbeitsablauf [17], HubSpot senkte im April von 1 US-Dollar je Gespräch auf 0,50 je gelöstem Gespräch [18], und Zendesk lässt die abgerechneten Lösungen von einem zweiten KI-Modell verifizieren, bezahlt wird nur der bestätigte Erfolg [19]. Für unsere 10.000 Kundenanfragen existieren damit zwei Welten: als Token-Rechnung ein zweistelliger Dollarbetrag, als Ergebnis-Rechnung beim Anbieter mehrere tausend Dollar, wenn man die 50 bis 99 Cent je gelöstem Fall hochrechnet (eigene Kalkulation). Die Spanne dazwischen ist Marge, Risiko und Verifikationsaufwand des Anbieters.
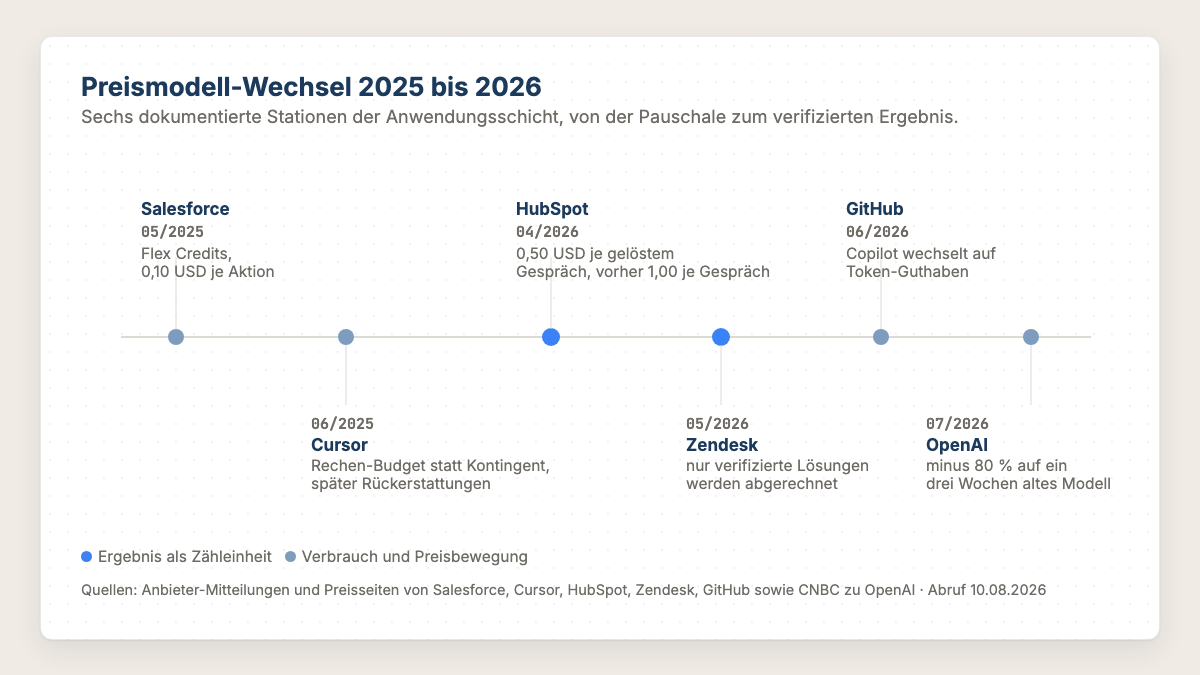
Im deutschsprachigen Raum hat SAP eine eigene Antwort gewählt: eine konzernweite Vorauszahl-Währung namens AI Units, aus der KI-Funktionen über alle Produkte hinweg schöpfen. Ein Joule-Beraterpaket etwa bündelt 22.900 Anfragen je Nutzer und Monat, gepoolt über alle Nutzer [20]. Die Treppe ordnet die Logik; am Markt verdichtet sie sich zu vier Grundtypen von Preismodellen.
| Kriterium | Preis je Nutzer | Verbrauch (Token, Credits) | Preis je Ergebnis | Hybrid (Sockel plus Komponente) |
|---|---|---|---|---|
| Zähleinheit | Arbeitsplatz | Token, Aktion, Guthaben | Gelöster Fall | Sockel plus Verbrauch oder Ergebnis |
| Kostenrisiko trägt | Anbieter | Kunde | Anbieter | geteilt |
| Planbarkeit für den Kunden | hoch | niedrig | mittel | mittel bis hoch |
| Typischer Streitpunkt | ungenutzte Lizenzen | Verbrauchsspitzen | Wer verifiziert das Ergebnis? | Komplexität des Vertrags |
| Beispiel 2026 | Microsoft 365 Copilot | GitHub Copilot, SAP AI Units, Salesforce Agentforce | Intercom, HubSpot, Zendesk | verbreitetster Typ: 37 % der B2B-SaaS-Anbieter |
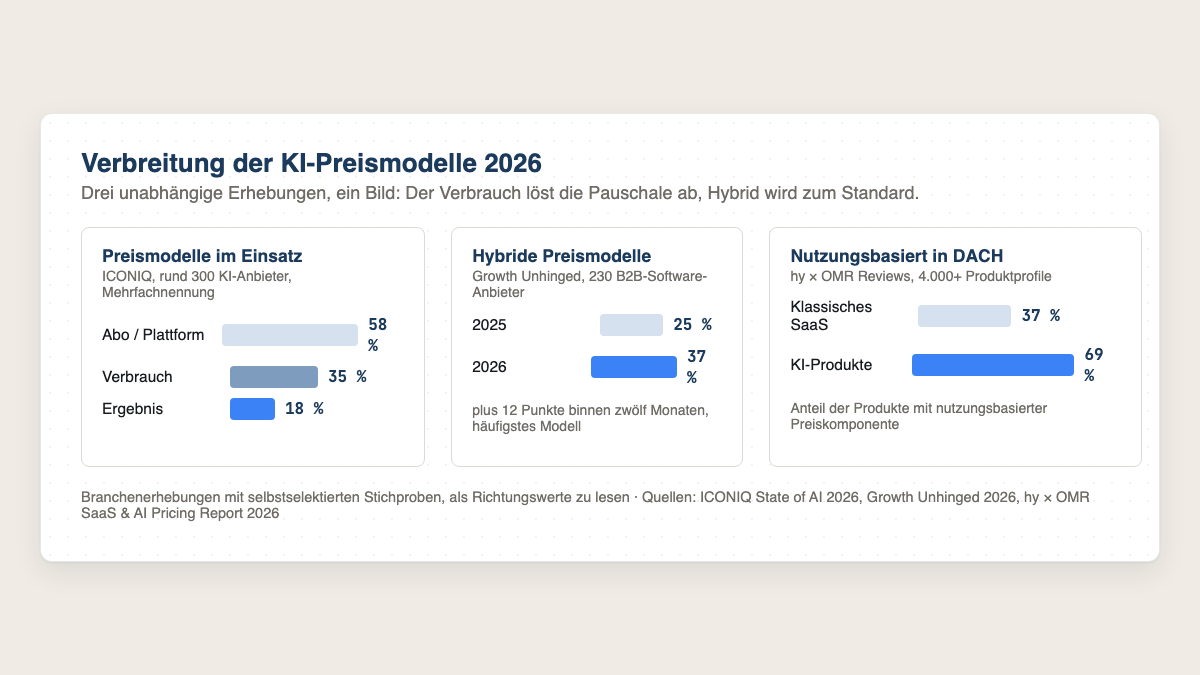
Die Zahlen zur Verbreitung passen zur Erzählung. Unter gut 300 befragten KI-Anbietern rechnen 58 Prozent per Abo, 35 Prozent nach Verbrauch und 18 Prozent nach Ergebnis, Mehrfachnennungen inklusive [4]. Das hybride Modell ist unter 230 B2B-Software-Anbietern binnen zwölf Monaten von 25 auf 37 Prozent gesprungen und damit das häufigste [1]. In der DACH-Empirie zeigt sich derselbe Bruch: Klassisches SaaS wird hier zu 92 Prozent im Abo verkauft, bei KI-Produkten springt der Anteil nutzungsbasierter Preise auf 69 Prozent [21]. Und 45 Prozent der Software-Anbieter fahren bereits zwei oder mehr Preismodelle parallel [5]. Hinter all dem steht eine alte Preisregel, die im KI-Zeitalter neu zieht: Der Preis gehört an die Einheit, die mit dem Kundennutzen mitwächst.
Was das für Software-Verträge und die Doppelzahlungs-Falle aus Lizenz plus Guthaben bedeutet, habe ich in SaaS-Preismodelle im Agenten-Zeitalter beschrieben, die Dienstleistungsseite in Honorarmodelle im KI-Zeitalter.
Wer prüft das Ergebnis, für das Sie zahlen?
Bezahlt wird nur der gelöste Fall. Das Zahlungsrisiko wandert damit tatsächlich zum Anbieter; beim Kunden bleibt das Informationsproblem, also die Frage, was dieses Ergebnis überhaupt wert ist. Die Forschung der letzten zwölf Monate zeigt ziemlich genau, warum das so schwer wiegt.
Das beginnt eine Ebene tiefer, als die meisten vermuten. Schickt man derselben KI tausendmal dieselbe Frage bei Temperatur null, also mit ausgeschaltetem Zufall, kommen im heutigen Normalbetrieb Dutzende verschiedene Antworten zurück; ein dokumentierter Versuch zählte 80 unterschiedliche aus 1.000 Anläufen [26]. Der Grund ist banal: Wie viele andere Kunden gerade dieselben Server nutzen, verändert die Rechenreihenfolge und damit das Ergebnis [26]. Allein die Serving-Konfiguration, also Batchgröße, GPU-Typ und Kartenzahl, kann die gemessene Lösequote eines offenen Modells um bis zu 9 Prozentpunkte verschieben [27]. Selbst der Anbieter sagt sein Produkt im Normalbetrieb also nur ungefähr vorher; abstellbar wäre das, es kostet nur Serving-Effizienz [26].
Dazu kommt die Zeitachse. Modelle hinter Schnittstellen ändern ihr Verhalten, ohne dass der Kunde davon erfährt: Dieselben Aufgaben löste GPT-4 im März 2023 zu 84 Prozent, im Juni 2023 zu 51 Prozent [28]. Die Software-Engineering-Forschung führt solche stillen Anbieter-Updates 2026 als eigenes Governance-Problem [29]. Und ob hinter der Schnittstelle wirklich das bezahlte Modell arbeitet, kann ein Kunde mit Software-Mitteln praktisch kaum verlässlich prüfen; ausgerechnet der Nichtdeterminismus lässt die statistischen Tests scheitern, belastbare Prüfung erfordert nach heutigem Forschungsstand spezielle Hardware oder kryptographische Verfahren [30].
Jetzt die Anreizseite. Dass ein Anbieter bei festem Ergebnispreis das billigste gerade noch ausreichende Modell einsetzen kann, ist in der Ökonomie als Moral Hazard formal beschrieben [31]; die Vertragstheorie hat ergebnisgebundene Verträge sogar als Gegenmittel gegen genau diesen Anreiz bei Token-Preisen entworfen [31]. Ein Feldnachweis, dass Anbieter tatsächlich still verbilligen, existiert übrigens nicht. Was begutachtet existiert: Wo eine KI die Zielerreichung einer anderen KI bewertet, urteilt sie systematisch verzerrt, bis hin zur Bevorzugung verwandter Modelle [32]. Ökonomisch ist eine KI-Leistung damit ein Vertrauensgut wie eine Autoreparatur, der Anbieter weiß mehr über die angemessene Leistung als der Kunde, und Experimente zeigen, dass diese Asymmetrie zulasten der Kunden wirkt [33].
Für unsere 10.000 Kundenanfragen heißt das: Die mehreren tausend Dollar Ergebnis-Rechnung sind nur dann ein fairer Tausch, wenn die Messung stimmt. Wer verifiziert, was gelöst heißt, mit welchem Modell gearbeitet wird und wie sich die Qualität über die Laufzeit hält, ist deshalb eine Vertragsfrage.
Mit wem schließen Sie eigentlich den KI-Vertrag?
Wer von einem KI-Vertrag spricht, meint drei sehr verschiedene Dinge. Große Unternehmen verhandeln Enterprise-Rahmenverträge direkt mit den Modellanbietern; der Mittelstand kauft dieselbe Technik meist als Standard-Abo von der Stange, knapp drei Viertel der KI-nutzenden Unternehmen in Deutschland zahlen für externe KI-Lösungen [45]. Dazwischen liegen zwei Produktwelten: etablierte Software, die KI-Funktionen auf ihr bestehendes Preismodell aufsetzt, und KI-native Produkte, die es ohne KI gar nicht gäbe. In unserem Werkzeugkasten führen wir genau diese Unterscheidung als eigene Dimension jedes Werkzeugprofils („Etabliert“, „Etabliert, KI nachgerüstet“, „KI-nativ“), weil sich daran entscheidet, welche Vertragsfragen zählen.
Beim Vertrag direkt mit dem Modellanbieter ist die wichtigste Zahl die Lebensdauer des Modells. OpenAI garantiert für ausgereifte Modelle mindestens sechs Monate Abkündigungsvorlauf, Anthropic mindestens 60 Tage, und in Microsofts Azure-Katalog steht der Satz, den man gelesen haben sollte: „Retirement dates aren't extendable“ [34][35][36]. Preise und Bedingungen darf der Anbieter einseitig anpassen, wesentliche Änderungen mit rund 30 Tagen Vorlauf, bei OpenAI wie bei Anthropic [46][37]; reduziert ein Update die Funktionalität wesentlich, bleibt bei OpenAI ein Kündigungsrecht mit nur fünf Geschäftstagen Reaktionsfrist [46]. Datierte Modell-Snapshots lassen sich festpinnen, sie sichern aber nur konstantes Verhalten, kein Weiterleben des Modells [35]. Und Enterprise heißt dabei längst nicht Großkonzern: Anthropic verkauft seinen Enterprise-Plan ab 20 Plätzen im Selbstbedienungskauf, die Nutzung kommt zu API-Preisen obendrauf [38].
Bei nachgerüsteter Bestandssoftware stapeln sich drei Zahlschichten: Basislizenz, KI-Zuschlag je Nutzer, Verbrauchsguthaben. Die Guthaben verfallen, bei HubSpot wörtlich am Ende jeder Abrechnungsperiode, bei Salesforce zum Vertragsende, bei SAP nach zwölf Monaten [39][14][20]. Und welches Modell hinter der Funktion arbeitet, sichert niemand zu: Salesforce beschreibt sein Standardmodell als „managed mix of trusted models (currently including GPT-4o)“ [40], Microsoft orchestriert im Copilot seit Herbst 2025 auch Anthropic-Modelle, gehostet außerhalb der eigenen Bedingungen [41]. Der Vertragsinhalt steckt in dem Wort „currently“.
KI-native Produkte sind die beweglichste Gruppe, beim Preis wie beim Unterbau. Replit bepreist seit 2025 nach Aufwand je Arbeitsschritt, von sechs Cent bis mehrere Dollar für dieselbe Einheit [43]; Cursors Bedingungen erlauben, Funktionen „at any time … without notice“ zu ändern oder einzustellen [42]. Und das Modell hinter dem Produkt kann über Nacht kippen: Windsurf verlor im Juni 2025 mit weniger als fünf Tagen Vorlauf fast den gesamten Zugang zu den Claude-Modellen seines Zulieferers [44]. Wer ein KI-natives Produkt einführt, kauft eine Wette auf dessen Lieferkette mit.
| Kriterium | Modellanbieter direkt | Etabliert, KI nachgerüstet | KI-nativ |
|---|---|---|---|
| Typischer Einkauf | Enterprise-Rahmenvertrag oder Self-Serve-API | Add-on zur Bestandslizenz plus Guthaben | Abo oder Credits, teils Preis je Ergebnis |
| Was sich ändern kann | Modell-Abkündigung (6 Monate bis 60 Tage Vorlauf), Preise und Bedingungen (rund 30 Tage) | Modell hinter der Funktion („managed mix“), Guthaben-Regeln | Preismodell selbst, Modell-Lieferkette, Funktionsumfang |
| Guthaben-Verfall | keiner (Pay-as-you-go) | monatlich bis Vertragsende | je Produkt verschieden, oft variabel je Aufgabe |
| Wichtigste Vertragsfrage | Lebensdauer und Snapshot-Pfad des Modells | Gesamtkosten je Fall über alle drei Schichten | Bestandsschutz bei Preis- und Modellwechsel |
Drei von vier Anfragen brauchen kein Spitzenmodell
Quer über alle Stufen der KI-Preistreppe liegt ein Hebel, der erst sichtbar wird, wenn Unternehmen mehrere Modelle kombinieren. Der Durchschnittsbetrieb nutzt bereits 3,1 Modellanbieter parallel [4], meist ohne System. Dabei funktioniert die Sortierung wie im Versandraum: Niemand schickt jeden Brief per Expresskurier, und von unseren 10.000 Kundenanfragen sind die meisten Routine und wenige heikel.
Wie viel diese Sortierung wert ist, hat die Berkeley-Arbeit RouteLLM gemessen: Ein trainierter Verteiler schickte nur gut jede fünfte Anfrage zum teuren Modell statt jeder zweiten bei zufälliger Verteilung und hielt dabei 95 Prozent der Qualität des Spitzenmodells [22]. In einer Produktionsumgebung senkte ein kalibrierter Verteiler die reinen Modellkosten um 31 Prozent bei stabiler Güte [23]. Als Größenordnung gilt: ein Drittel bis zwei Drittel der Kosten, immer bezogen auf eine erklärte Qualitätsschwelle.
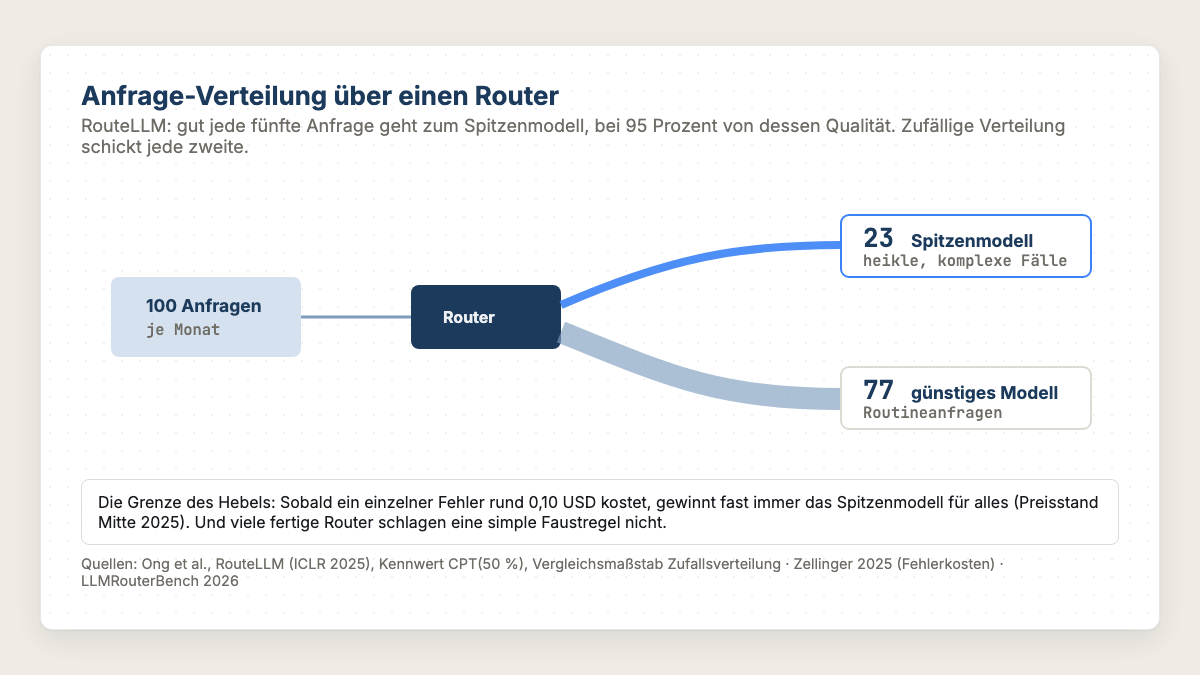
Zwei Einschränkungen gehören dazu, sonst wird das hier Werbung. Erstens schlagen viele fertige Verteiler, auch kommerzielle, eine simple Faustregel nicht, das zeigt ein Vergleich über 400.000 Testfälle [24]. Zweitens gilt die Fehlerkosten-Schwelle von eben auch hier: Sobald ein Fehler richtig Geld kostet, gewinnt das eine Spitzenmodell gegen jede Kombination [13]. Bei Agenten, die selbstständig in mehreren Schritten arbeiten, fällt die Modellwahl zudem längst je Arbeitsschritt und die Kombination wird zur Architekturfrage.
Damit lässt sich das Beispiel einmal komplett durchrechnen, alle Werte eigene Kalkulation auf Basis der zitierten Listenpreise, Stand 10.08.2026:
| Stufe | Rechnung | Ergebnis |
|---|---|---|
| 1 · Token-Preis | 10.000 Anfragen × rund 3.700 Token auf einem günstigen Modell [6] | ~37 USD je Monat |
| 2 · Tarifmechanik | Cache-Lesen zu 0,1× und Batch zu 0,5× senken, Kontextstaffel und Denk-Token treiben [6][8][9] | grob 20 bis 75 USD, je nach Zuschnitt |
| 3 · Preis je Fähigkeit | dieselbe Leistungsklasse kostet ein Jahr später den Faktor 5 bis 10 weniger [10] | Budget hält, der Anspruch wächst mit |
| 4 · Kosten je gelöster Aufgabe | 37 USD ÷ 0,8 Lösequote, den Rest arbeitet ein Mensch nach [12] | ~46 USD plus Nacharbeitszeit |
| 5 · Preis je Ergebnis | 8.000 gelöste Fälle × 0,50 bis 0,99 USD beim Anbieter [17][18] | 4.000 bis 7.920 USD je Monat |
Wie bringen Sie Ordnung in Ihre KI-Preisfindung?
- Datieren Sie jeden Preisstand. Schreiben Sie an jede KI-Kalkulation das Abrufdatum der Anbieter-Preisseiten, und behandeln Sie jede Zahl ohne Datum als veraltet. Mein eigener Rechner war trotz täglicher Nutzung zweimal binnen zwei Wochen überholt, das Problem trifft also auch Leute, die es hauptberuflich versuchen.
- Messen Sie eine Woche lang die Kosten je gelöster Aufgabe. Lassen Sie eine echte Arbeitslast parallel auf einem günstigen und einem starken Modell laufen und zählen Sie mit, wie viele Ergebnisse ohne Nacharbeit brauchbar sind. Für die Rechnung dahinter, inklusive Anläufen, Cache und Nacharbeit, können Sie den KI-Kostenrechner nutzen.
- Verhandeln Sie die Zähleinheit vor dem Preis. Als Einkäufer fragen Sie: Was genau zählt der Anbieter, wer verifiziert ein gelöstes Ergebnis, was passiert oberhalb des Kontingents? Als Anbieter wählen Sie die Einheit, die mit dem Nutzen Ihres Kunden mitwächst, und steigen realistischerweise hybrid ein, mit Sockel und Ergebniskomponente.
- Definieren Sie Ihre Fehlerkosten-Schwelle. Beziffern Sie je Aufgabentyp, was ein falsches Ergebnis kostet. Oberhalb der Schwelle arbeitet das beste verfügbare Modell, unterhalb das günstigste, das die Qualitätsschwelle hält.
Ein Wort zur Umstellung selbst, denn sie ist Kommunikationsarbeit. Cursor hat 2025 vorgeführt, wie ein sachlich vertretbarer Preiswechsel zum Reputationsschaden wird, wenn Kunden ihn erst auf der Rechnung bemerken [16]. Vor jeden Wechsel des eigenen KI-Preismodells gehören deshalb eine Ankündigung, vorgerechnete Beispiele und eine Übergangsfrist für Bestandskunden.
Meine Einordnung
Die Preisdebatte wird als Anbieterthema geführt, dabei verschiebt sie gerade die Anforderungen an den Einkauf. Wer 2026 KI-Verträge unterschreibt, braucht Kompetenzen, die bisher in der Produktion saßen: Erfolgsquoten messen, Qualitätsschwellen definieren, Verifikation verhandeln. Die Einkaufsabteilungen, die ich sehe, sind darauf selten vorbereitet, und die Anbieter wissen das.
Bemerkenswert finde ich, wie offen die Anbieterseite ihr eigenes Suchen dokumentiert. Wenn 37 Prozent der KI-Anbieter ankündigen, ihr Preismodell binnen zwölf Monaten zu ändern [4], ist jeder Vertrag dieser Tage ein Experiment, an dem beide Seiten lernen. Das spricht für kurze Laufzeiten und eingebaute Anpassungsklauseln, auf beiden Seiten des Tisches. Vielleicht unterschätze ich auch, wie lange Übergangszustände sich halten können. Und ob am Ende überhaupt noch jemand Token zählt oder nur noch Ergebnisse... ich traue mich nicht, das zu datieren.
Eine Beobachtung zum Schluss. Als ich Ende Juli fünf marktübliche KI-Kostenrechner verglichen habe (eigene Erhebung), konnte keiner von ihnen Kosten je gelöster Aufgabe ausweisen, alle rechneten in Token. Der Markt diskutiert öffentlich über die oberste Stufe der KI-Preistreppe und seine Werkzeuge stehen noch auf der untersten.
Häufige Fragen
Was ist die KI-Preistreppe?
Ein Ordnungsmodell für KI-Preismodelle in fünf Stufen: Preis je Token, Tarifmechanik (Cache, Batch, Kontextstaffeln), Preis je Fähigkeit, Kosten je gelöster Aufgabe und Preis je Ergebnis. Mit jeder Stufe wandert das Kostenrisiko weiter vom Kunden zum Anbieter.
Welche KI-Preismodelle gibt es 2026?
Vier Grundtypen: Preis je Nutzer, Verbrauchspreise über Token oder Guthaben, Preis je Ergebnis und hybride Modelle aus Sockel plus Komponente. Hybride Modelle sind mit 37 Prozent inzwischen am weitesten verbreitet, ergebnisbasierte Preise führen Anbieter wie Intercom, HubSpot und Zendesk als Listenpreis.
Warum ist das billigste KI-Modell oft nicht das günstigste?
Weil die Gesamtkosten von Erfolgsquote und Denk-Token abhängen. In 32 Prozent der untersuchten Modellpaare verursacht das billiger gelistete Modell höhere Gesamtkosten, weil mehr Anläufe und längeres Nachdenken den Listenpreisvorteil aufzehren.
Was ist Outcome-Pricing bei KI?
Ein Preismodell, bei dem nur das verifizierte Ergebnis bezahlt wird, etwa ein gelöstes Kundenanliegen. Intercom berechnet 0,99 US-Dollar je Ergebnis, HubSpot 0,50 US-Dollar je gelöstem Gespräch, Zendesk lässt Lösungen vor der Abrechnung von einem zweiten KI-Modell bestätigen.
Verlagert der Preis je Ergebnis das Risiko zum Anbieter?
Das Zahlungsrisiko ja, bezahlt wird nur der gelöste Fall. Das Informationsproblem bleibt beim Kunden: Was als gelöst zählt, misst meist der Anbieter selbst, KI-Richter urteilen nachweislich verzerrt, und Modellwechsel hinter der Schnittstelle sind mit Software kaum prüfbar.